업데이트: 2026년 11월 3일. 팩터 평가 지표의 정의와 점검 순서를 다루는 방법 칼럼입니다. 코드의 수치는 무작위로 만든 가상 패널에서 나온 예시이며, 실제 팩터나 전략의 성과가 아닙니다.
IC는 예측과 결과의 상관이며, 수익과 같은 말이 아니다
IC(Information Coefficient)는 예측값과 실제 결과 사이의 상관계수입니다. Grinold와 Kahn의 Active Portfolio Management에서 IC는 예측 능력을 나타내는 척도이며, 실무에서는 특정 시점의 종목별 팩터 값과 이후 수익률의 횡단면 상관으로 계산합니다. 피어슨 상관을 쓰기도 하고, 이상치 영향을 줄이려고 순위 상관(스피어만, rank IC)을 쓰기도 합니다. 오픈소스 라이브러리 Alphalens의 factor_information_coefficient는 기간별 스피어만 순위 상관을 계산합니다.
IC가 수익과 연결되는 방식은 이른바 적극적 운용의 기본 법칙으로 설명됩니다. 정보비율은 대략 IC와 독립적인 베팅 수(breadth)의 제곱근의 곱입니다. Clarke, de Silva, Thorley(2002)는 여기에 이전계수(transfer coefficient)를 곱해, 공매도 금지나 비중 한도 같은 제약이 예측을 포지션으로 옮기는 효율을 떨어뜨린다는 점을 보였습니다.
이 식에서 바로 보이는 것은, IC가 같아도 베팅이 독립적이지 않거나, 제약이 많거나, 비용이 크면 결과가 달라진다는 점입니다. 기본 식에는 거래 비용이 들어 있지 않습니다. 아래 점검은 이 빈칸을 채우는 순서입니다.
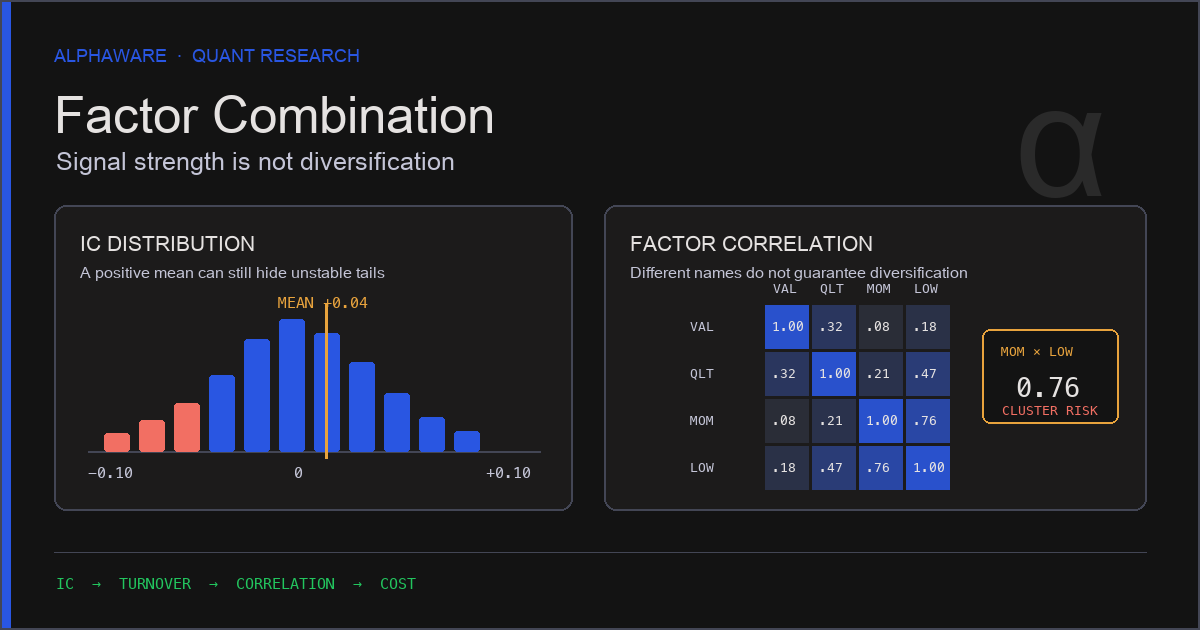
IC의 평균보다 기간별 분포를 본다
IC는 기간마다 하나씩 나오는 시계열입니다. 평균이 같아도 매 기간 비슷한 값이 나오는 팩터와 크게 오르내리는 팩터는 다르게 다뤄야 합니다. 흔히 쓰는 요약은 ICIR, 즉 IC 평균을 IC 표준편차로 나눈 값입니다.
import numpy as np
import pandas as pd

rng = np.random.default_rng(0)
n_dates, n_assets = 120, 200
dates = pd.date_range("2024-01-05", periods=n_dates, freq="W-FRI")
assets = [f"A{i:03d}" for i in range(n_assets)]

# 가상 패널: 팩터는 천천히 변하고, 다음 기간 수익률에 약한 신호만 섞었다
factor = np.zeros((n_dates, n_assets))
factor[0] = rng.normal(size=n_assets)
for t in range(1, n_dates):
    factor[t] = 0.8 * factor[t - 1] + 0.6 * rng.normal(size=n_assets)
noise = rng.normal(size=(n_dates, n_assets))
fwd_ret = 0.05 * factor + noise   # 행 t: t 시점 이후 한 기간 수익률
factor = pd.DataFrame(factor, index=dates, columns=assets)
fwd_ret = pd.DataFrame(fwd_ret, index=dates, columns=assets)

def rank_ic(f, r):
    """날짜별 횡단면 스피어만 IC = 순위끼리의 피어슨 상관."""
    fr = f.rank(axis=1)
    rr = r.rank(axis=1)
    fr = fr.sub(fr.mean(axis=1), axis=0)
    rr = rr.sub(rr.mean(axis=1), axis=0)
    return (fr * rr).sum(axis=1) / np.sqrt((fr**2).sum(axis=1) * (rr**2).sum(axis=1))

ic = rank_ic(factor, fwd_ret)
icir = ic.mean() / ic.std(ddof=1)
t_stat = icir * np.sqrt(ic.count())   # IC가 서로 독립이라는 가정에서만의 근사

print(f"IC mean {ic.mean():.4f}  IC std {ic.std(ddof=1):.4f}  ICIR {icir:.3f}  t~{t_stat:.2f}")
print(f"share of periods with IC > 0: {(ic > 0).mean():.2f}")

# 순위 IC는 같은 날짜의 단조 변환에 영향을 받지 않는다
assert np.allclose(rank_ic(np.exp(factor), fwd_ret), ic)
assert ic.between(-1, 1).all()
assert ic.mean() > 0
ICIR에 기간 수의 제곱근을 곱하면 IC 평균의 t-통계량에 가까운 값이 됩니다. 다만 이 근사는 기간별 IC가 서로 독립일 때만 성립합니다. 예측 기간이 리밸런싱 간격보다 길어 수익률 구간이 겹치면 IC가 서로 상관되므로, 그대로 쓰면 유의성을 과대평가합니다.
ICIR이 얼마 이상이면 “안정적”이라는 보편적인 기준은 확인하지 못했습니다. 기준값은 자산군, 유니버스 크기, 리밸런싱 주기에 따라 달라지므로, 결과를 보기 전에 스스로 정하고 기록해 두는 편이 낫습니다. IC가 양수인 기간의 비율, 최근 구간과 과거 구간의 차이, 시장 국면별 평균도 함께 보면 평균 하나에 가려진 정보를 볼 수 있습니다.
순위 자기상관이 낮으면 비용 추정부터 한다
팩터 순위가 기간마다 크게 바뀌면 포트폴리오도 자주 바뀝니다. Alphalens 문서는 팩터 값이 아니라 순위의 기간 간 자기상관을 회전율 척도로 쓰며, 순위가 매 기간 무작위로 바뀌면 자기상관이 0에 가깝다고 설명합니다. 값 대신 순위를 쓰는 이유는 전체 종목의 팩터 값이 함께 이동하는 효과를 제거하기 위해서입니다.
여러 종목을 한 줄로 이어 붙인 시계열에 autocorr()를 적용하면 종목 경계가 섞여 이 의미가 사라집니다. 날짜별 횡단면 순위끼리 비교해야 합니다.
import numpy as np
import pandas as pd

rng = np.random.default_rng(1)
n_dates, n_assets = 104, 200

def ar_factor(phi):
    """자기상관 phi를 갖는 가상 팩터 패널 (날짜 x 종목)."""
    x = np.zeros((n_dates, n_assets))
    x[0] = rng.normal(size=n_assets)
    for t in range(1, n_dates):
        x[t] = phi * x[t - 1] + np.sqrt(1 - phi**2) * rng.normal(size=n_assets)
    return pd.DataFrame(x)

def rank_autocorr(f, lag=1):
    """날짜 t와 t-lag의 횡단면 순위 상관. 팩터 값의 전체 이동은 순위에서 제거된다."""
    r = f.rank(axis=1)
    return r.corrwith(r.shift(lag), axis=1).dropna()

def top_quintile_turnover(f):
    """상위 20% 동일가중 롱 포트폴리오의 회당 단방향 회전율."""
    w = f.rank(axis=1, pct=True).gt(0.8).astype(float)
    w = w.div(w.sum(axis=1), axis=0)
    return 0.5 * w.diff().abs().sum(axis=1).iloc[1:]

def annual_cost(turnover, cost_rate, periods_per_year):
    """연간 비용 ~ 연간 리밸런싱 횟수 x 회당 회전율 x 거래금액 대비 비용률."""
    return periods_per_year * turnover.mean() * cost_rate

slow, fast = ar_factor(0.95), ar_factor(0.30)
for name, f in [("slow", slow), ("fast", fast)]:
    to = top_quintile_turnover(f)
    print(f"{name}: rank autocorr {rank_autocorr(f).mean():.2f}, "
          f"turnover {to.mean():.2f}, annual cost {annual_cost(to, 0.001, 52):.2%}")

assert rank_autocorr(slow).mean() > rank_autocorr(fast).mean()
assert top_quintile_turnover(slow).mean() < top_quintile_turnover(fast).mean()
# 매주 전량 교체(회전율 1.0)에 비용 0.1%를 가정할 때에만 연 5.2%가 된다
assert np.isclose(annual_cost(pd.Series([1.0]), 0.001, 52), 0.052)
“거래비용 0.1%에 주 1회 리밸런싱이면 연 5% 비용”이라는 계산은 매주 포트폴리오를 전부 교체한다는 가정에서만 맞습니다. 이 가상 예시에서 순위 자기상관이 0.95인 팩터는 회당 회전율이 약 18%, 0.30인 팩터는 약 66%였고, 같은 비용률에서 연간 비용 추정치가 몇 배 차이 났습니다. 실제 비용은 스프레드, 시장 충격, 수수료, 세금, 공매도 비용에 따라 달라지므로, 비용률을 바꿔 가며 결과의 민감도를 확인합니다.
비슷한 팩터를 여러 개 더하면 같은 베팅이 커진다
팩터를 여러 개 결합해도 서로 같은 정보를 측정한다면 독립적인 베팅이 늘지 않습니다. 기본 법칙의 breadth는 독립적인 베팅의 수이므로, 상관이 높은 팩터를 더하는 것은 분산이라기보다 한 신호의 비중을 키우는 것에 가깝습니다. 예를 들어 같은 가격 이력을 다른 길이로 잘라 만든 모멘텀 팩터들은 계산 구간이 겹치므로 서로 상관될 가능성이 큽니다. 실제 상관 수준은 데이터로 확인해야 합니다.
import numpy as np
import pandas as pd

rng = np.random.default_rng(2)
n_dates, n_assets = 104, 200

def xs_rank_corr(a, b):
    """날짜별 두 팩터의 횡단면 순위 상관을 구한 뒤 평균."""
    return a.rank(axis=1).corrwith(b.rank(axis=1), axis=1).mean()

base = pd.DataFrame(rng.normal(size=(n_dates, n_assets)))
near_copy = base + 0.3 * rng.normal(size=base.shape)      # 거의 같은 정보를 다시 측정
other = pd.DataFrame(rng.normal(size=(n_dates, n_assets)))  # 별개의 정보

c_dup, c_ind = xs_rank_corr(base, near_copy), xs_rank_corr(base, other)
print(f"near-copy corr {c_dup:.2f}, independent corr {c_ind:.2f}")
assert c_dup > 0.8 and abs(c_ind) < 0.05

# 예측 기간별 IC: 팩터(t)와 k기간 뒤 한 기간 수익률의 순위 상관
phi = 0.7
f = np.zeros((n_dates, n_assets))
f[0] = rng.normal(size=n_assets)
for t in range(1, n_dates):
    f[t] = phi * f[t - 1] + np.sqrt(1 - phi**2) * rng.normal(size=n_assets)
f = pd.DataFrame(f)
ret = 0.1 * f + rng.normal(size=f.shape)   # 행 t: t에서 t+1까지 수익률

ic_by_lag = {k: xs_rank_corr(f, ret.shift(-k)) for k in [0, 1, 2, 4, 8]}
for k, v in ic_by_lag.items():
    print(f"lag {k}: IC {v:.4f}")
assert ic_by_lag[0] > ic_by_lag[2] > ic_by_lag[8]
상관 행렬은 전 기간을 한 번에 섞어 계산하기보다, 위처럼 날짜별 횡단면 상관을 구한 뒤 평균과 변동을 보는 편이 팩터 결합의 의미에 맞습니다. 상관이 높은 쌍을 발견했을 때 하나를 빼거나, 회귀로 직교화하거나, 주성분으로 묶는 선택지가 있습니다. 어느 수준부터 정리할지는 미리 정한 기준과 결합 후 IC·회전율 변화를 보고 판단합니다.
예측 기간별 IC로 리밸런싱 주기의 후보를 정한다
위 코드의 두 번째 부분은 팩터를 계산한 시점과 수익률 구간 사이의 지연을 늘려 가며 IC를 계산합니다. 지연이 커질수록 IC가 얼마나 빨리 줄어드는지가 팩터 예측력의 수명입니다. 가상 예시에서는 지연 0에서 약 0.10이던 IC가 지연 8에서 0 근처로 내려갔습니다.
이 곡선은 리밸런싱 주기의 후보를 줍니다. IC가 천천히 줄어든다면 리밸런싱을 덜 자주 해 비용을 아끼는 방안을 시험할 수 있고, 빨리 줄어든다면 자주 리밸런싱해야 예측력을 쓸 수 있지만 앞 절의 비용 추정이 더 중요해집니다. 최종 선택은 주기별로 비용 차감 후 성과를 비교해 정합니다.
누적 수익률 구간(예: 1·5·21일 누적)으로 IC를 비교할 때는, 구간이 길수록 겹치는 관측이 많아져 IC 시계열의 자기상관이 커진다는 점도 함께 고려합니다.
편입 전 점검 순서
아래 순서는 결과를 보기 전에 기준값을 정해 두고 적용하는 것을 전제로 합니다.
- 기존 팩터와의 중복: 날짜별 횡단면 순위 상관의 평균과 변동을 확인합니다. 높으면 제거, 직교화, 결합 방식을 결정합니다.
- IC의 분포: 평균, 표준편차, ICIR, 양수 비율, 구간별 차이를 봅니다. 수익률 구간이 겹치면 t-통계량을 그대로 믿지 않습니다.
- 순위 자기상관과 회전율: 실제로 만들 포트폴리오 규칙으로 회당 회전율을 계산하고, 비용률을 바꿔 가며 연간 비용을 추정합니다.
- 예측 기간별 IC: 감소 속도로 리밸런싱 주기 후보를 정합니다.
- 비용 차감 후 검증: 후보 주기별로 비용과 제약을 반영해 시간순 검증을 합니다. 분할 방법은 과적합 점검 칼럼에서 다룹니다.
자료와 적용 범위
- Clarke, de Silva, Thorley (2002), Portfolio Constraints and the Fundamental Law of Active Management, Financial Analysts Journal 58(5): Grinold의 기본 법칙에 이전계수를 더한 일반화. IC와 breadth의 정의는 Grinold & Kahn, Active Portfolio Management(2판, McGraw-Hill, 2000)를 따릅니다.
- Alphalens API 문서:
factor_information_coefficient(기간별 스피어만 IC)와factor_rank_autocorrelation(순위 자기상관을 회전율 척도로 사용)의 정의. - ICIR·회전율·비용의 기준값은 이 글에서 제시하지 않습니다. 이 글은 팩터 평가 절차를 설명할 뿐, 특정 팩터나 결합 방식이 초과수익을 낸다고 주장하지 않습니다.