업데이트: 2026년 11월 3일. 2026년 4월판의 모델별 비교를 결정 기준 중심으로 다시 썼습니다. 모델 ID·단가·제한은 2026년 11월 3일 Anthropic 공식 문서로 확인한 값이고, 라우팅·검증 코드는 이 글에서 제안하는 설계이며 실제 API 호출이나 벤치마크는 하지 않았습니다.
모델 이름 대신 결정 기준을 남긴다
이 글의 4월판은 Claude 3.5 Sonnet과 GPT-4o를 이름과 단가로 비교했습니다. 그런데 Anthropic의 모델 지원 중단 문서에 따르면 claude-3-5-sonnet-20241022는 2025년 10월 28일에 이미 은퇴했고, 은퇴한 모델로 보낸 요청은 실패합니다. 모델 비교표는 몇 달이면 낡고, 낡은 표는 그대로 코드에 남습니다. 모델 지원 중단 문서
오래 유지되는 것은 모델 이름이 아니라 어떤 작업을 어떤 조건으로 맡기는가입니다. 이 글은 다섯 가지 기준으로 정리합니다.
- 작업 형태: 대화형 분석인가, 대량 배치 추출인가, 코드 변경인가.
- 컨텍스트 길이: 한 번에 넣어야 하는 자료가 얼마나 긴가.
- 비용 구조: 같은 지시문이 반복되는가, 응답을 기다려야 하는가.
- 출력 형식: 결과를 사람이 읽는가, 프로그램이 저장하는가.
- 데이터 민감도: 외부 전송과 보존이 허용되는 자료인가.
2026년 11월 3일 기준 Anthropic 모델 개요 문서는 현재 모델로 Claude Fable 5.1(claude-fable-5-1), Claude Opus 5.5(claude-opus-5-5), Claude Sonnet 5.5(claude-sonnet-5-5), Claude Haiku 5.5(claude-haiku-5-5)를 나열합니다. 같은 문서는 대부분의 작업을 Opus 5.5에서 시작하라고 안내하고, Haiku 5.5를 분류·추출·라우팅 같은 대량·저지연 작업용으로 설명합니다. 다만 이 목록도 바뀝니다. 코드에는 모델 ID를 설정값으로 두고, 바꿀 때마다 자신의 평가 세트로 다시 확인하는 편이 안전합니다. 모델 개요
작업 형태에 따라 호출 방식이 달라진다
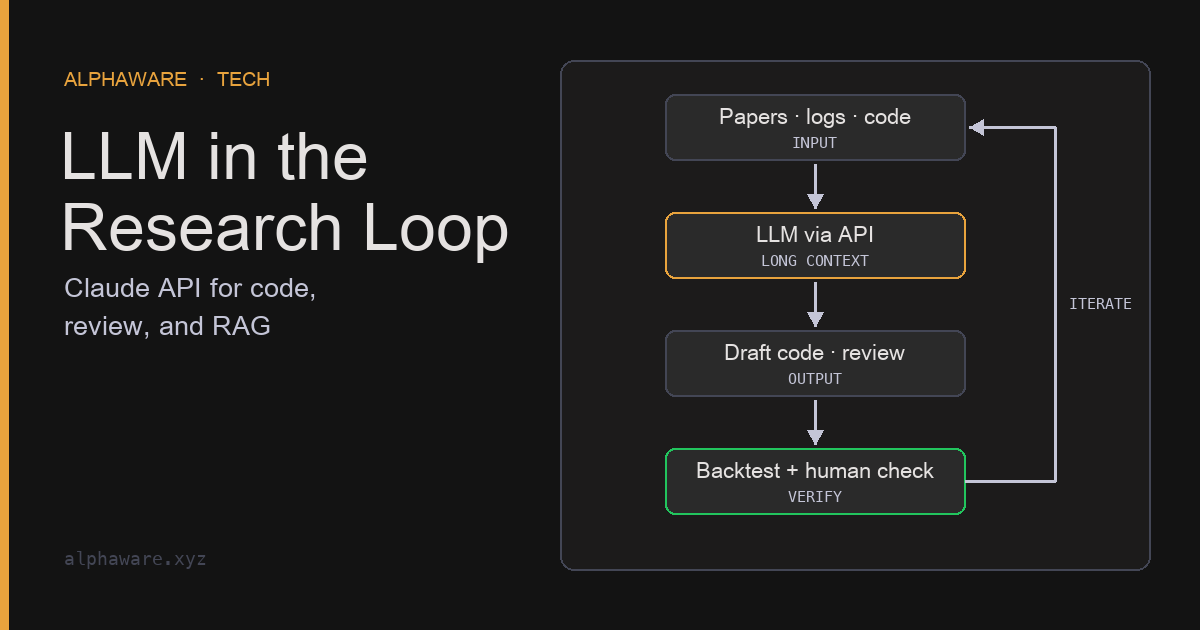
LLM에 “BTC가 어디로 갈까”를 묻는 것은 검증할 수 없는 질문입니다. 리서치 자동화에 맞는 작업은 결과를 확인할 수 있는 작업입니다. 논문의 팩터 정의를 코드로 옮기기, 백테스트 로그에서 조사할 구간 고르기, 공시 문서에서 수치 추출하기가 그런 예입니다.
| 작업 형태 | 먼저 볼 조건 | 맞는 호출 방식 |
|---|---|---|
| 대화형 분석·코드 리뷰 | 응답 품질, 왕복 시간 | 동기 Messages API |
| 대량 문서 추출·분류 | 건당 비용, 처리량, 형식 | Message Batches API + 구조화된 출력 |
| 같은 자료에 반복 질문 | 반복되는 접두부 길이 | 프롬프트 캐싱 |
| 저장소 단위 코드 변경 | 파일 권한, 테스트, 리뷰 | 에이전트형 코딩 도구 |
마지막 줄의 예가 Claude Code입니다. 공식 문서는 Claude Code를 코드베이스를 읽고, 파일을 수정하고, 명령을 실행하는 에이전트형 코딩 도구로 설명하며 터미널, IDE, 데스크톱 앱, 브라우저에서 쓸 수 있다고 안내합니다. 파일을 직접 바꾸는 도구이므로 전략 코드 저장소에서는 변경을 브랜치로 분리하고, 테스트와 사람의 리뷰를 거친 뒤 반영하는 경계가 필요합니다. Claude Code 개요
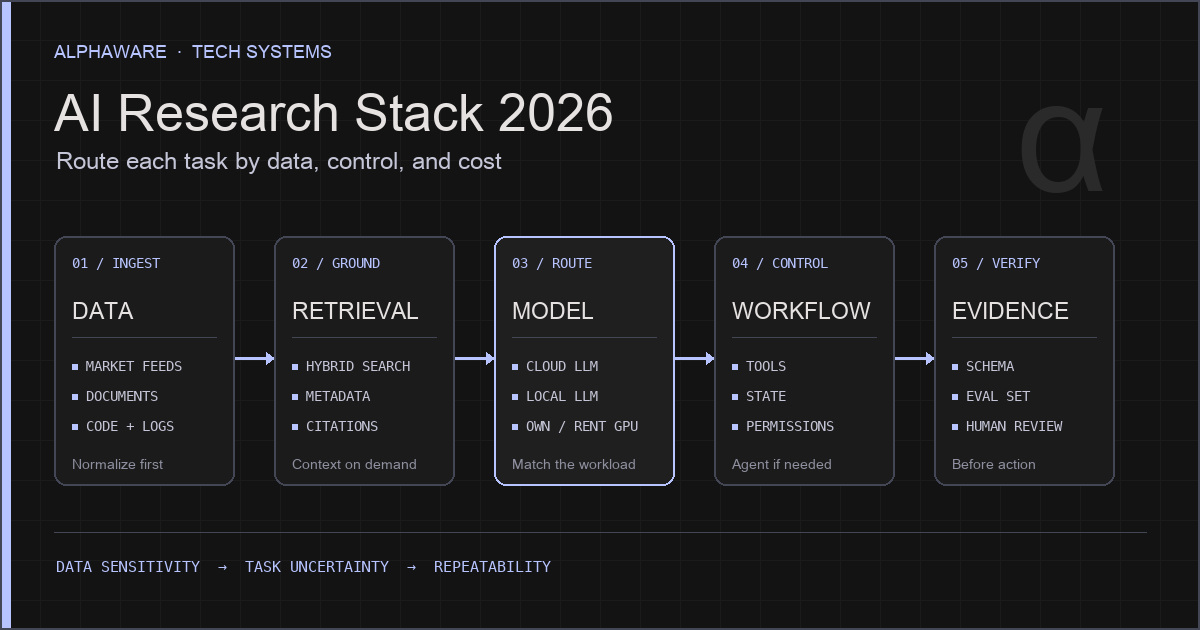
워크플로와 에이전트를 언제 나누는지는 AI 리서치 스택 칼럼에서 더 다룹니다.
긴 컨텍스트는 비용과 검증 부담도 키운다
2026년 11월 3일 기준 모델 개요 문서에서 현재 네 모델은 모두 100만 토큰 컨텍스트와 12만 8천 토큰 최대 출력을 표기합니다. 논문 여러 편이나 큰 코드 파일을 한 요청에 넣을 수 있다는 뜻입니다. 그렇다고 항상 모두 넣는 것이 좋은 것은 아닙니다.
- 요금: 입력 토큰은 넣은 만큼 청구됩니다. Haiku 5.5는 프롬프트가 10만 토큰을 넘으면 더 높은 단가가 적용됩니다.
- 토큰 수: 가격 문서는 Claude 4.7 이후 모델의 토크나이저가 같은 텍스트에서 이전 모델보다 약 30% 많은 토큰을 만든다고 설명합니다. 이전 모델 기준 예산을 그대로 옮기지 말고 토큰 계산 API로 다시 재야 합니다.
- 근거 추적: 자료가 길수록 답이 어느 구절에서 나왔는지 확인하기 어렵습니다. 문서와 구절에 ID를 붙이고, 응답이 그 ID를 인용하게 하는 편이 검증하기 쉽습니다.
정리하면 기준은 “한 번에 넣을 수 있는가”가 아니라 “이 질문에 그 자료가 모두 필요한가“입니다. 필요한 부분만 검색해 넣는 구조는 AI 리서치 스택 칼럼의 RAG 절에서 설명합니다.
비용은 단가가 아니라 호출 구조로 계산한다
2026년 11월 3일 기준 Anthropic 가격 문서의 기본 단가는 다음과 같습니다(USD, 100만 토큰당).
| 모델 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 |
| Claude Haiku 5.5 (프롬프트 10만 토큰 이하) | $0.10 | $0.50 | $0.01 |
단가보다 총비용을 크게 바꾸는 것은 호출 구조입니다. 같은 문서 기준으로 두 가지를 확인할 수 있습니다.
- 배치 처리: Message Batches API는 입력·출력 모두 50% 할인됩니다. 한 배치는 요청 10만 건 또는 256MB까지이고, 대부분 1시간 안에 끝나지만 24시간 안에 처리되지 않은 요청은 만료됩니다. 결과는 생성 후 29일 동안 내려받을 수 있습니다. 배치 처리
- 프롬프트 캐싱: 5분 캐시 쓰기는 기본 입력 단가의 1.25배, 1시간 쓰기는 2배이고, 캐시 읽기는 0.1배입니다(Opus 5.5와 Sonnet 5.5는 0.05배). 기본 수명은 5분이며 사용할 때마다 갱신됩니다. 현재 모델의 최소 캐시 길이는 512토큰이고, 그보다 짧으면 오류 없이 캐시되지 않습니다. 프롬프트 캐싱
아래 코드는 같은 지시문과 스키마 6,000토큰에 문서 3,000토큰을 붙여 1,000건을 처리하는 가상의 작업을 세 방식으로 계산합니다. 단가는 위 표의 Sonnet 5.5 값이며 API를 호출하지 않습니다.
# 2026-11-03 기준 Claude Sonnet 5.5 단가 (USD / 100만 토큰)
# 출처: https://platform.claude.com/docs/en/about-claude/pricing
PRICE = {"input": 2.00, "output": 10.00,
         "cache_write_5m": 2.50, "cache_read": 0.10}
BATCH_DISCOUNT = 0.5

def job_cost(n_docs, prefix_tokens, doc_tokens, out_tokens,
             price, mode="standard"):
    """문서 n_docs건을 같은 지시문(prefix)으로 처리하는 비용(USD)."""
    if mode == "cached":
        # 첫 요청이 캐시를 쓰고, 이후 요청이 캐시를 읽는다고 가정
        prefix = (price["cache_write_5m"] * prefix_tokens
                  + price["cache_read"] * prefix_tokens * (n_docs - 1))
    else:
        prefix = price["input"] * prefix_tokens * n_docs
    body = (price["input"] * doc_tokens
            + price["output"] * out_tokens) * n_docs
    total = (prefix + body) / 1_000_000
    return total * BATCH_DISCOUNT if mode == "batch" else total

args = dict(n_docs=1_000, prefix_tokens=6_000,
            doc_tokens=3_000, out_tokens=400, price=PRICE)
standard = job_cost(**args)
cached = job_cost(**args, mode="cached")
batch = job_cost(**args, mode="batch")

assert round(standard, 2) == 22.00
assert round(cached, 2) == 10.61
assert round(batch, 2) == 11.00
assert cached < batch < standard
이 계산의 캐시 시나리오는 요청이 5분 간격 안에 계속 이어져 캐시가 유지된다는 가정에 기대고 있습니다. 배치 시나리오는 캐시 적중을 가정하지 않았습니다. 실제 비용은 응답의 usage 필드에 기록된 캐시 쓰기·읽기 토큰으로 확인해야 하며, 재시도와 검토 시간도 총비용에 넣어야 합니다.
다른 공급자도 같은 틀로 비교할 수 있습니다. OpenAI 가격 페이지도 표준 요금과 별도로 배치 요금과 캐시 입력 요금을 표기합니다. 단가표를 옮겨 적기보다 자신의 호출 구조를 위 함수에 넣어 보는 편이 덜 낡습니다. OpenAI API 가격
구조화된 출력은 형식만 보장한다
결과를 프로그램이 저장한다면 자유 형식 답변보다 스키마를 지정하는 편이 낫습니다. Anthropic 문서는 output_config.format에 JSON 스키마를 넣어 응답 형식을 제한하는 방법을 설명합니다. 같은 문서는 minimum·maximum 같은 수치 제약과 minLength 같은 문자열 제약을 지원하지 않는 기능으로 나열하고, 거절(refusal)이나 토큰 한도(max_tokens)로 멈춘 응답은 스키마와 맞지 않을 수 있다고 적습니다. 구조화된 출력
아래 코드는 요청 본문을 만들고, 가짜 응답으로 저장·재시도·보류를 가르는 로컬 로직만 검증합니다. 네트워크와 API 키 없이 실행됩니다.
import json

MODEL = "claude-sonnet-5-5"  # 예시 ID. 모델 개요 문서에서 현재 ID를 다시 확인
SCHEMA = {
    "type": "object",
    "properties": {
        "metric": {"type": "string"},
        "period": {"type": "string"},
        "value": {"type": "string"},
        "unit": {"type": "string"},
        "passage_id": {"type": "string"},
    },
    "required": ["metric", "period", "value", "unit", "passage_id"],
    "additionalProperties": False,
}

def build_request(doc_id, passages):
    body = "\n".join(f'<passage id="{pid}">{text}</passage>'
                     for pid, text in passages.items())
    return {
        "model": MODEL,
        "max_tokens": 1024,
        "system": "Extract one figure. Cite only passage ids that appear "
                  "in the document. If no figure is stated, say so.",
        "messages": [{"role": "user",
                      "content": f'<document id="{doc_id}">\n{body}\n</document>'}],
        "output_config": {"format": {"type": "json_schema", "schema": SCHEMA}},
    }

def route(response, passage_ids):
    """응답을 store / retry / hold 중 하나로 보낸다."""
    stop = response["stop_reason"]
    if stop == "max_tokens":
        return "retry", "truncated"
    if stop != "end_turn":          # refusal 등
        return "hold", stop
    text = next(b["text"] for b in response["content"] if b["type"] == "text")
    data = json.loads(text)
    if set(data) != set(SCHEMA["required"]):
        return "hold", "unexpected_keys"
    if data["passage_id"] not in passage_ids:
        return "hold", "unknown_passage"
    return "store", data

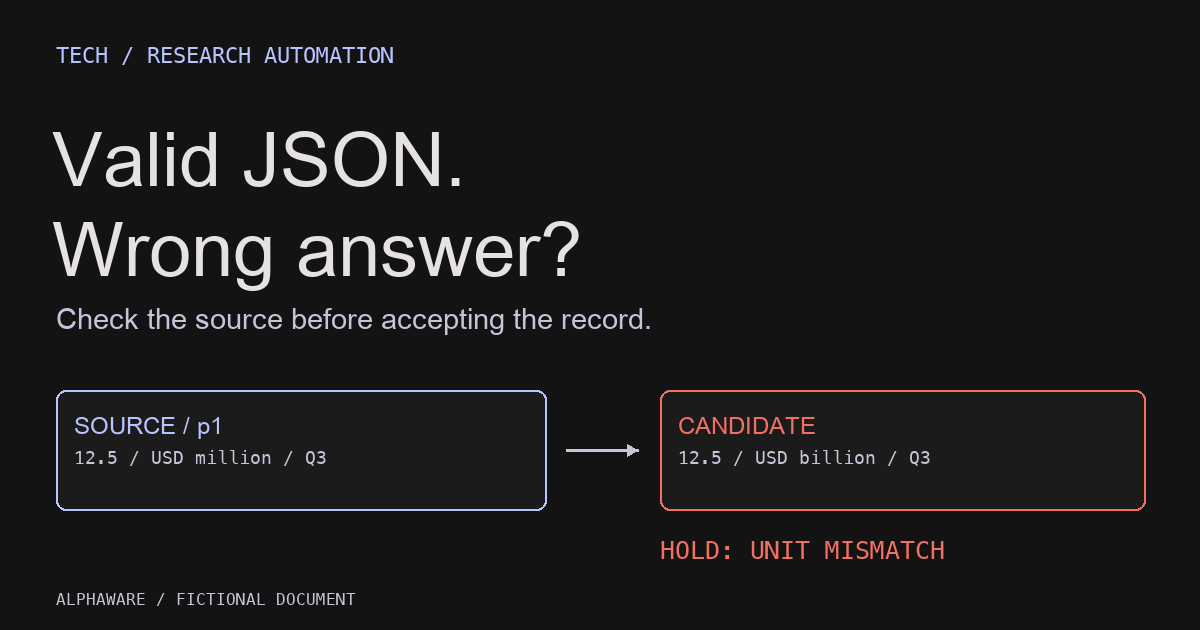
passages = {"p1": "Revenue for Q3 was USD 12.5 million."}
request = build_request("demo-report", passages)
assert request["output_config"]["format"]["schema"]["additionalProperties"] is False
assert 'id="p1"' in request["messages"][0]["content"]

def fake(stop, payload=None):
    content = [] if payload is None else [{"type": "text", "text": json.dumps(payload)}]
    return {"stop_reason": stop, "content": content}

good = {"metric": "revenue", "period": "Q3", "value": "12.5",
        "unit": "USD million", "passage_id": "p1"}
assert route(fake("end_turn", good), passages) == ("store", good)
assert route(fake("end_turn", {**good, "passage_id": "p9"}), passages) == ("hold", "unknown_passage")
assert route(fake("refusal"), passages) == ("hold", "refusal")
assert route(fake("max_tokens"), passages) == ("retry", "truncated")
실제 호출은 공식 Python SDK에 위에서 만든 요청 본문을 그대로 넘기면 됩니다. 아래 블록은 API 키와 네트워크가 필요하므로 이 글에서 실행하지 않았습니다. 형태는 구조화된 출력·배치 처리 문서의 Python 예시를 따릅니다.
# 실행하지 않음: ANTHROPIC_API_KEY와 네트워크 필요
import json
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()

# 동기 호출 1건
response = client.messages.create(**build_request("demo-report", passages))
text = next(block.text for block in response.content if block.type == "text")
record = json.loads(text)

# 같은 요청을 배치로 제출 (결과는 custom_id로 매칭)
batch = client.messages.batches.create(
    requests=[
        Request(
            custom_id="demo-report",
            params=MessageCreateParamsNonStreaming(**build_request("demo-report", passages)),
        )
    ]
)store로 분류되었다고 수치가 사실이라는 뜻은 아닙니다. 구절 ID가 존재하고 형식이 맞는다는 것까지만 확인했습니다. 수치가 원문과 일치하는지 대조하는 단계는 구조화된 출력과 근거 검증 칼럼에서 이어서 다룹니다.
민감한 데이터는 보존 조건부터 확인한다
전략 코드나 포지션을 보내기 전에 확인할 것은 “학습에 쓰이는가”만이 아닙니다. 저장되는지, 얼마나 오래, 어떤 기능에서 저장되는지가 같이 중요합니다. 2026년 11월 3일 기준 Anthropic의 API 데이터 보존 문서는 다음을 설명합니다. API 데이터 보존
- 보존된 데이터는 명시적 허락 없이 모델 학습에 쓰이지 않습니다.
- 무보존(ZDR)은 기본값이 아니라 영업팀을 통해 조직 단위로 적용하는 약정입니다.
- Message Batches API는 ZDR 대상이 아니며 29일 보존이 적용됩니다. 비용을 줄이려 배치로 옮기면 보존 조건도 바뀝니다.
- Claude Fable 5.1과 Fable 5는 30일 보존이 필요한 모델로, 별도 승인 없이는 ZDR 환경에서 쓸 수 없습니다.
- 약정과 무관하게 법적 요구나 자동 안전 시스템에 걸린 내용은 최대 2년 보존될 수 있습니다.
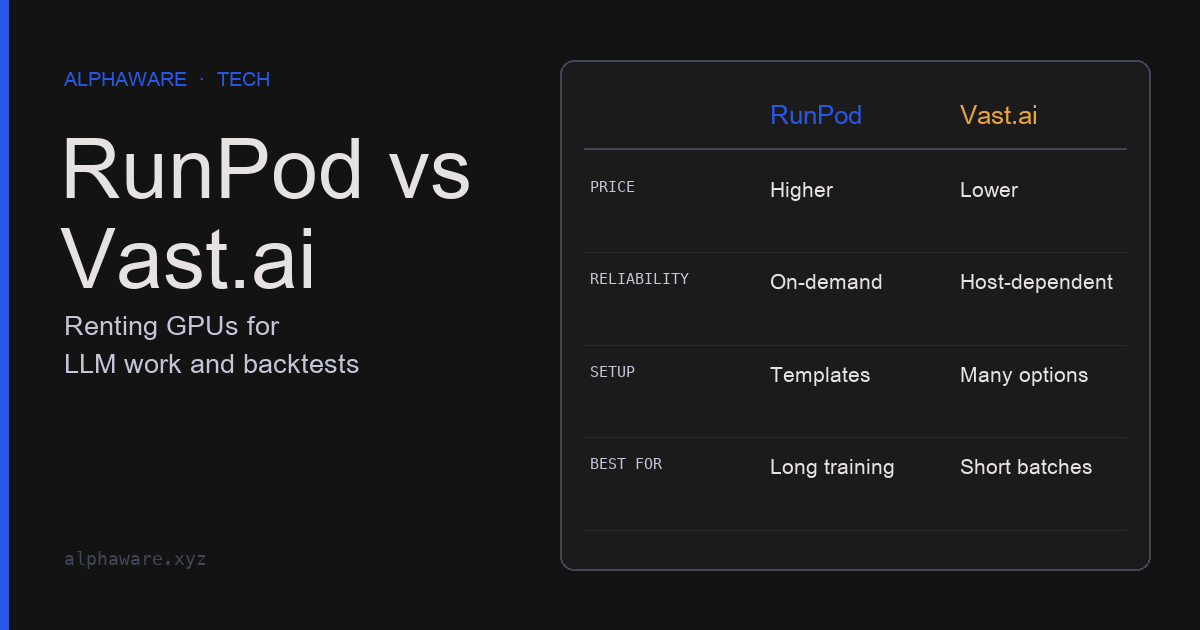
조건이 맞지 않는 자료는 외부 API로 보내지 않는 경로가 필요합니다. 로컬 모델을 어디에 두고 어떤 기준으로 나누는지는 로컬 LLM과 클라우드 API 칼럼에서 다룹니다. 계약 조건은 조직마다 다르므로 최종 판단은 자신의 계약서와 담당자 확인을 기준으로 해야 합니다.
자료와 적용 범위
- Anthropic 모델 개요: 현재 모델 ID, 컨텍스트 길이, 최대 출력, 기본 단가.
- Anthropic 모델 지원 중단: Claude 3.5 Sonnet 은퇴일과 은퇴 모델 요청 실패.
- Anthropic 가격: 모델별 단가, 캐시 배수, 배치 할인, 토크나이저 차이.
- Anthropic 배치 처리: 배치 한도, 만료, 결과 보관 기간.
- Anthropic 프롬프트 캐싱: 캐시 수명과 최소 길이.
- Anthropic 구조화된 출력:
output_config.format요청 형태와 스키마 제약. - Anthropic API 데이터 보존: 학습 사용, ZDR, 기능별 보존 조건.
- Claude Code 개요: 에이전트형 코딩 도구의 기능과 사용 환경.
- OpenAI API 가격: 배치·캐시 입력 요금이 별도로 표기된다는 점만 참고했습니다.
- 비용 계산과 라우팅 코드는 가상 작업에 대한 설계 예시입니다. 모델 간 품질 비교나 벤치마크는 하지 않았고, 특정 모델이 퀀트 작업에 더 낫다고 주장하지 않습니다.