업데이트: 2026년 11월 3일. 2026년 4월판의 모델·GPU 이름 비교를 선택 기준 중심으로 다시 썼습니다. Ollama·Anthropic·OpenAI 관련 사실은 2026년 11월 3일 공식 문서로 확인했고, 비용 계산과 라우팅 규칙은 가상 숫자를 쓴 설계 예시이며 모델 성능 벤치마크는 하지 않았습니다.
질문은 ’어느 쪽이 나은가’가 아니라 ‘어떤 작업을 어디서 돌리는가’

사진: Trần Chính / Pexels
리서치에 LLM을 붙이면 세 가지 질문이 곧 나옵니다. 전략 코드나 포지션 데이터를 외부 API에 보내도 되는가. 배치 처리량이 늘면 비용이 감당되는가. 응답 품질이 작업에 충분한가.
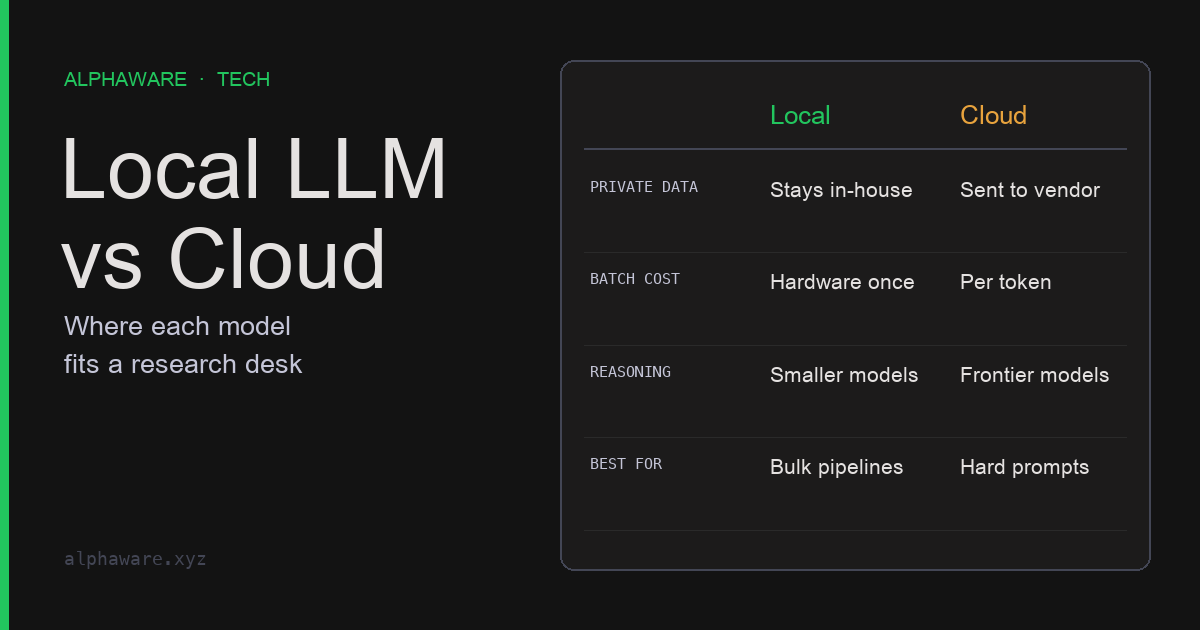
4월판은 이 질문에 특정 모델과 GPU 이름으로 답했습니다. 그런 비교는 새 모델이 나오면 바로 낡습니다. 대신 작업마다 다음 네 가지를 정하면, 모델이 바뀌어도 판단 구조는 유지됩니다.
| 기준 | 로컬 쪽으로 기우는 조건 | 클라우드 쪽으로 기우는 조건 |
|---|---|---|
| 데이터 민감도 | 계약상 외부 전송 불가 | 외부 처리와 보존 조건이 허용됨 |
| 사용량과 가동률 | 장비를 꾸준히 채울 만큼 반복 작업이 많음 | 사용량이 적거나 들쭉날쭉함 |
| 필요한 품질·컨텍스트 | 짧은 입력, 정해진 형식의 분류·요약 | 긴 문서, 복잡한 코드, 여러 단계 추론 |
| 운영 여력 | 장비·보안·업데이트를 관리할 사람이 있음 | 운영 부담을 줄이고 싶음 |
어느 열이 맞는지는 표가 아니라 자신의 작업으로 측정해야 합니다. 아래 절은 각 기준을 확인하는 방법입니다.
데이터 경계: 로컬도 설정에 따라 밖으로 나간다
로컬 모델의 장점은 실행 경계를 직접 소유한다는 점입니다. 2026년 11월 3일 기준 Ollama FAQ는 로컬에서 실행할 때 프롬프트와 데이터를 보지 않는다고 설명합니다. 같은 FAQ에서 확인할 설정도 있습니다. Ollama FAQ
- Ollama는 기본적으로
127.0.0.1의 11434 포트에만 바인딩됩니다.OLLAMA_HOST로 바인딩 주소를 바꾸면 다른 기기에서 접근할 수 있으므로, 이때는 인증과 방화벽을 따로 설계해야 합니다. 로컬 API 요청에는 API 키가 필요하지 않습니다. Ollama API 소개 - Ollama는 클라우드 호스팅 모델도 제공합니다. 클라우드 모델을 쓰면 프롬프트가 기기 밖에서 처리됩니다. FAQ는 클라우드 기능을 끄는 로컬 전용 설정도 안내합니다.
- 모델 파일, 임베딩 저장소, 로그도 민감 자료를 담을 수 있으므로 접근 통제 대상입니다.
클라우드 쪽은 “학습에 쓰지 않는다”와 “저장하지 않는다”를 구분해 읽어야 합니다. 같은 날짜 기준으로 OpenAI는 API 데이터를 기본적으로 학습에 쓰지 않지만 악용 모니터링 로그를 최대 30일 보존할 수 있다고 설명합니다. 무보존 등 변경된 통제는 사전 승인이 필요합니다. OpenAI 데이터 통제 Anthropic은 보존된 데이터를 명시적 허락 없이 학습에 쓰지 않으며, 무보존(ZDR)은 조직 단위 약정이고 배치 API는 29일 보존이라 ZDR 대상이 아니라고 설명합니다. Anthropic API 데이터 보존
결론은 단순합니다. 계약상 외부로 보낼 수 없는 자료는 로컬 경로로만 처리하고, 그 경로가 실제로 기기 밖으로 나가지 않는지 설정까지 확인합니다.
비용: GPU는 무료가 아니라 가동률 문제다
“GPU가 있으면 사실상 무료”라는 4월판의 표현은 틀렸습니다. 장비 감가상각, 전력, 업데이트와 장애 대응 시간은 사용량이 0이어도 남는 고정비입니다. 반대로 API 비용은 사용량에 비례합니다. 그래서 비교 기준은 단가가 아니라 월 사용량이 어느 지점을 넘으면 고정비가 분산되는가입니다.
아래 코드는 모든 숫자가 가상 값인 손익분기 계산입니다. 자신의 장비 견적, 전기 요금, 운영 시간, 공급자 요금표로 바꿔 넣어야 의미가 있습니다.
# 모든 숫자는 가상 값입니다. 자신의 견적과 요금표로 바꿔 넣으세요.
def cloud_monthly(m_in, m_out, price_in, price_out):
    """월 입력·출력 토큰(백만 단위)과 100만 토큰당 단가로 계산한 API 비용."""
    return m_in * price_in + m_out * price_out

def local_monthly(hardware, life_months, power_kw, hours,
                  kwh_price, ops_hours, ops_rate):
    """감가상각 + 전력 + 운영 시간. 사용량이 0이어도 남는 고정비."""
    return (hardware / life_months
            + power_kw * hours * kwh_price
            + ops_hours * ops_rate)

local = local_monthly(hardware=6_000, life_months=36, power_kw=0.6,
                      hours=200, kwh_price=0.20, ops_hours=4, ops_rate=50)

def cloud_at(volume):
    # 가상 요청 비율: 입력 2, 출력 1 (백만 토큰 단위)
    return cloud_monthly(2 * volume, volume, price_in=1.0, price_out=5.0)

assert round(local, 2) == 390.67
assert cloud_at(10) == 70.0            # 적은 사용량: API가 저렴
assert cloud_at(60) == 420.0           # 많은 사용량: 고정비가 분산
breakeven = next(v for v in range(1, 1_000) if cloud_at(v) >= local)
assert breakeven == 56
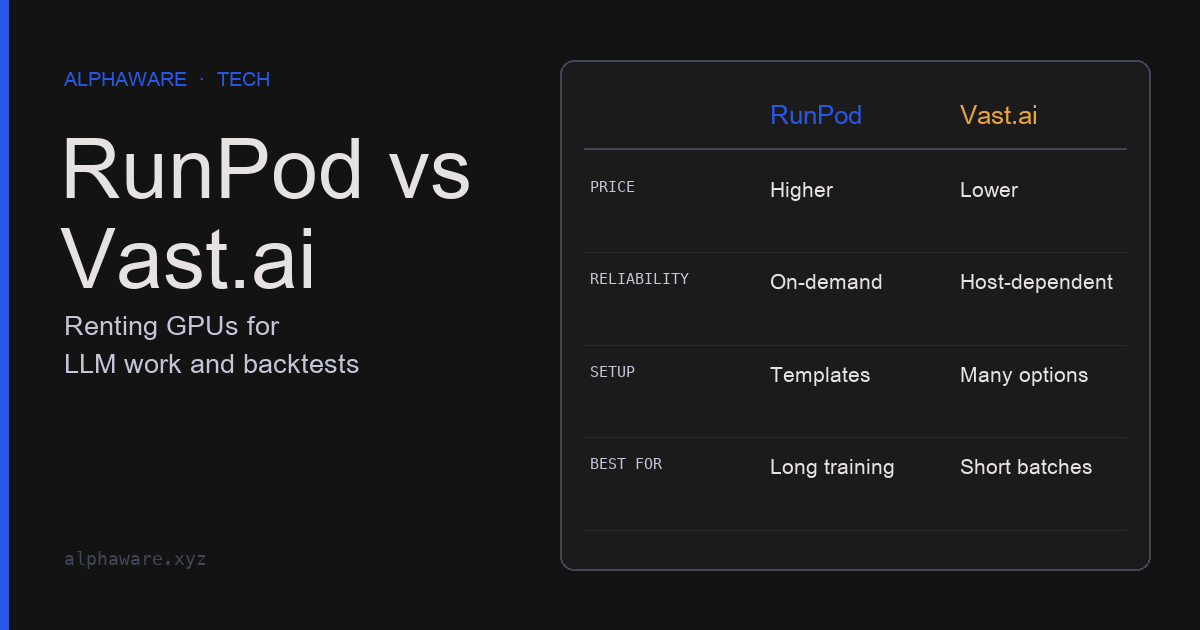
이 계산에는 빠진 항목이 있습니다. 로컬 모델이 같은 작업을 같은 품질로 처리한다는 가정, 처리량이 부족할 때의 대기 시간, 클라우드의 배치 할인과 프롬프트 캐싱입니다. 클라우드 쪽 호출 구조에 따른 비용 차이는 Claude API 칼럼에서 계산합니다. 장비를 사지 않고 GPU를 시간 단위로 빌리는 선택지도 있으며, 이때도 판단 기준은 가동률입니다.
품질과 컨텍스트: 자신의 평가 세트로 비교한다
4월판은 “70B 모델이면 클라우드와 비슷하다” 같은 일반론을 적었지만, 이런 비교는 모델 세대가 바뀔 때마다 달라지고 작업마다 결과가 다릅니다. 확인 가능한 것은 설정과 측정 방법입니다.
- 컨텍스트 설정: 2026년 11월 3일 기준 Ollama FAQ는 기본 컨텍스트 창을 4,096토큰으로 설명하고,
OLLAMA_CONTEXT_LENGTH환경 변수나 API 요청의num_ctx옵션으로 바꾸도록 안내합니다. 긴 문서를 넣었는데 결과가 이상하다면 모델보다 이 설정을 먼저 확인할 일입니다. - 메모리: 같은 FAQ는 병렬 요청 수만큼 컨텍스트 크기가 늘어나 메모리를 더 쓴다고 설명합니다. 컨텍스트를 늘리면 처리량이 줄 수 있습니다.
- 비교 방법: 실제 작업에서 뽑은 문서 수십 건에 사람이 정답을 붙이고, 로컬 후보와 클라우드 후보를 같은 프롬프트·같은 세트로 돌려 정답률, 형식 실패율, 건당 지연 시간을 기록합니다. 정답이 없는 입력에서 모델이 멈추는지도 따로 셉니다.
이 글은 그런 비교를 실행하지 않았습니다. 특정 로컬 모델이 특정 클라우드 모델과 대등하다는 주장도 하지 않습니다.
파이프라인에서는 같은 검증을 거친다
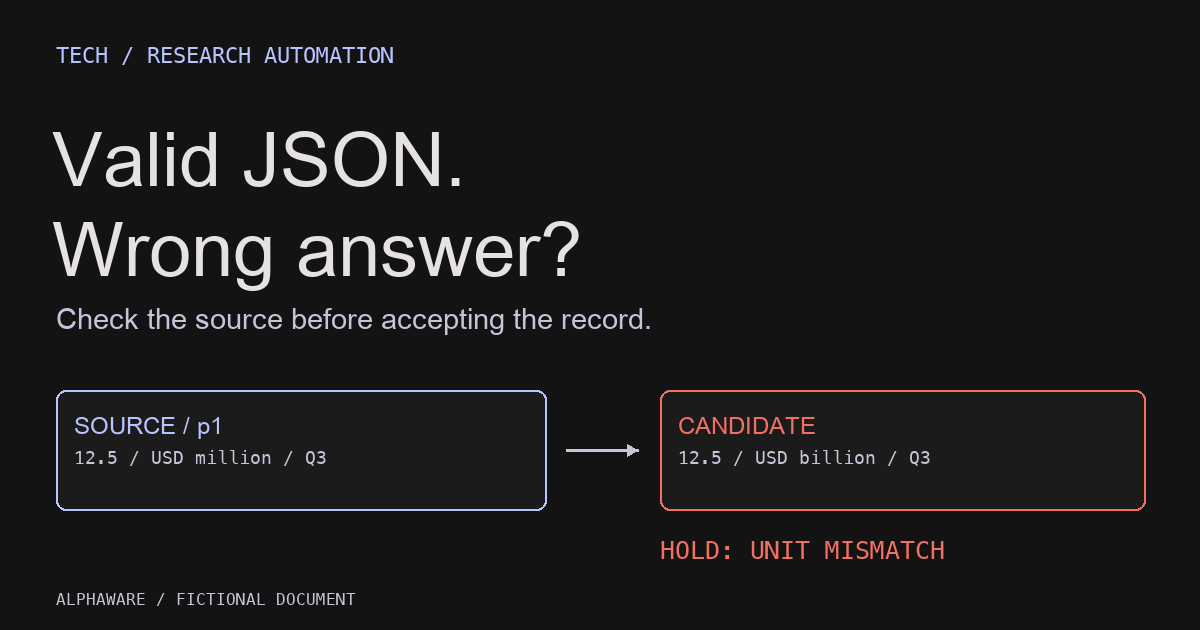
뉴스 분류나 문서 요약처럼 반복 호출하는 작업에서는 어느 쪽 모델이든 출력을 같은 검증 함수로 받아야 합니다. 그래야 모델을 바꿔도 하위 단계가 흔들리지 않습니다.
Ollama 문서는 format 필드에 JSON 스키마를 넘겨 출력 형식을 제한하는 방법을 설명합니다. 다만 같은 문서는 Ollama 클라우드가 현재 구조화된 출력을 지원하지 않는다고 적고 있습니다. Ollama 구조화된 출력 Anthropic API에서는 output_config.format이 같은 역할을 합니다. Anthropic 구조화된 출력
아래 블록은 로컬 Ollama 서버가 필요하므로 이 글에서 실행하지 않았습니다. 형태는 Ollama 문서의 Python 예시를 따르며, 모델 이름은 설치한 모델로 바꿔야 합니다.
# 실행하지 않음: 로컬 Ollama 서버와 내려받은 모델 필요
from ollama import chat
from pydantic import BaseModel
from typing import Literal

class Sentiment(BaseModel):
    label: Literal["positive", "negative", "neutral"]

response = chat(
    model="your-local-model",
    messages=[{"role": "user", "content": "Classify the market sentiment of: ..."}],
    format=Sentiment.model_json_schema(),
)
result = Sentiment.model_validate_json(response.message.content)
스키마를 지정해도 검증은 남겨 둡니다. 아래 함수는 네트워크 없이 실행되며, 실행 위치를 정하는 라우팅 규칙과 공통 출력 검증을 함께 보여 줍니다.
import json

LABELS = {"positive", "negative", "neutral"}

def route(job, local_ctx):
    """작업 속성으로 실행 위치를 정한다. local_ctx는 실제로 설정한 컨텍스트 길이."""
    if job["sensitivity"] == "restricted":
        return "local" if job["tokens"] <= local_ctx else "split_or_hold"
    if job["latency"] == "interactive":
        return "cloud_sync"
    return "cloud_batch"

def parse_label(text):
    """로컬·클라우드 어느 쪽이든 같은 검증을 거친다."""
    try:
        data = json.loads(text)
    except json.JSONDecodeError:
        return None
    label = str(data.get("label", "")).lower()   # 대소문자 차이 허용
    return label if label in LABELS else None

assert route({"sensitivity": "restricted", "tokens": 3_000,
              "latency": "batch"}, local_ctx=4_096) == "local"
assert route({"sensitivity": "restricted", "tokens": 9_000,
              "latency": "batch"}, local_ctx=4_096) == "split_or_hold"
assert route({"sensitivity": "public", "tokens": 9_000,
              "latency": "interactive"}, local_ctx=4_096) == "cloud_sync"
assert route({"sensitivity": "public", "tokens": 9_000,
              "latency": "batch"}, local_ctx=4_096) == "cloud_batch"

assert parse_label('{"label": "Negative"}') == "negative"
assert parse_label('{"label": "bullish"}') is None
assert parse_label("Negative.") is None
혼합 구성은 라우팅 규칙을 코드로 남긴다
현실적인 구성은 둘 중 하나를 고르는 것이 아니라 작업별로 경로를 나누는 것입니다. 위 route 함수의 핵심은 세 가지입니다.
- 민감 자료는 클라우드로 넘기지 않습니다. 로컬 컨텍스트에 들어가지 않으면 자동으로 클라우드에 보내지 말고, 나누거나 보류합니다. 편의를 위한 자동 대체가 데이터 경계를 무너뜨리는 가장 흔한 경로입니다.
- 기다릴 수 있는 작업은 배치로 보냅니다. 응답을 즉시 볼 필요가 없다면 배치 할인과 처리량을 활용할 수 있습니다. 단, 배치는 보존 조건이 다를 수 있습니다.
- 규칙은 설정과 코드에 남깁니다. 어떤 작업이 왜 어느 경로로 갔는지 로그에 남으면, 모델을 바꾸거나 계약 조건이 바뀌었을 때 영향을 추적할 수 있습니다.
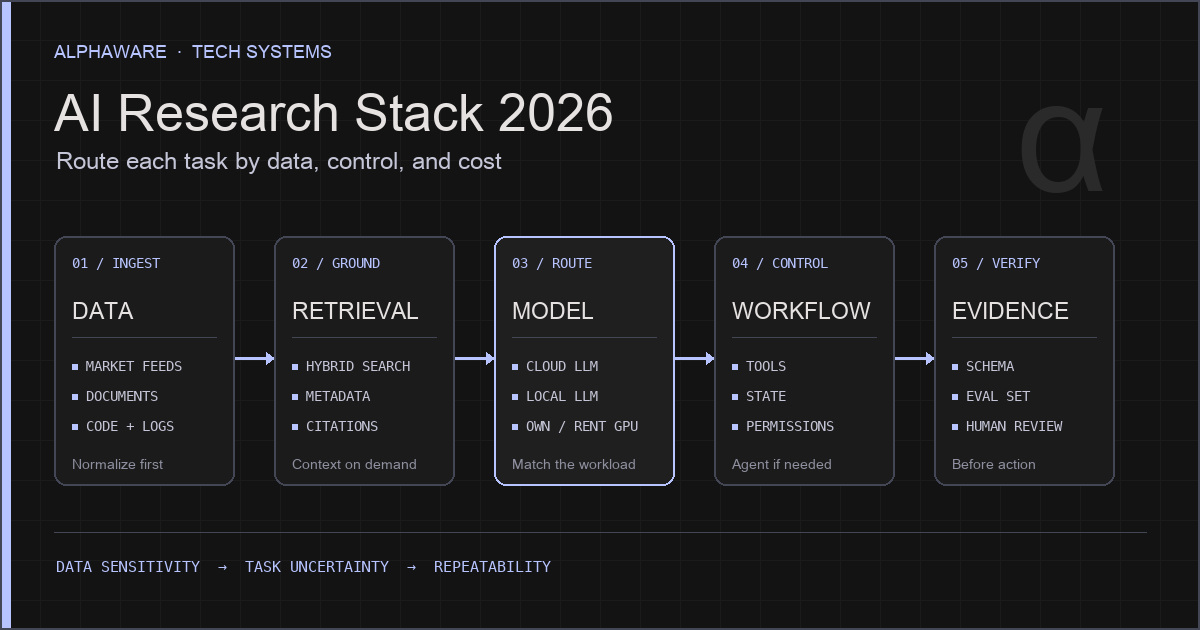
GPU 서버가 없다면 민감하지 않은 작업부터 클라우드 API로 시작하고, 민감 자료가 생기는 시점에 로컬 경로를 추가하는 순서도 가능합니다. 어느 경우든 프롬프트, 스키마, 평가 세트를 공급자와 분리해 두면 경로를 바꾸는 비용이 작아집니다. 전체 시스템에서 이 결정이 어디에 놓이는지는 AI 리서치 스택 칼럼에서 다룹니다.
자료와 적용 범위
- Ollama FAQ: 로컬 실행 시 데이터 처리, 기본 바인딩 주소, 기본 컨텍스트 4,096토큰과 변경 방법, 병렬 요청과 메모리, 클라우드 기능 비활성화.
- Ollama API 소개: 로컬 API 주소와 로컬 요청의 인증 불필요.
- Ollama 구조화된 출력:
format에 JSON 스키마 전달, 클라우드 미지원. - OpenAI API 데이터 통제: 기본 학습 미사용, 악용 모니터링 로그 최대 30일, 무보존 사전 승인.
- Anthropic API 데이터 보존: 학습 사용, ZDR 약정, 배치 29일 보존.
- Anthropic 구조화된 출력:
output_config.format. - 비용 계산의 숫자는 모두 가상 값이고, 라우팅 규칙은 이 글에서 제안하는 설계입니다. 로컬·클라우드 모델의 품질이나 속도를 측정한 벤치마크는 실행하지 않았습니다.