업데이트: 2026년 11월 3일. GPU별 시간당 가격 예시를 빼고, 2026년 11월 3일 확인한 공식 문서 기준으로 임대 유형과 과금 구조를 비교하도록 다시 썼습니다. 요금은 GPU·지역·시점에 따라 바뀌므로 아래 링크한 공식 가격 페이지에서 직접 확인하세요.
시간당 요금 하나로는 비교할 수 없다
GPU 클라우드를 고를 때 먼저 보이는 숫자는 GPU 시간당 요금입니다. 하지만 실제 청구액은 몇 가지가 더해져 결정됩니다. 작업이 중간에 멈출 수 있는지, 멈췄을 때 다시 돌린 시간, 작업이 끝난 뒤에도 남는 디스크 요금, 결과를 내려받는 전송 요금입니다.
RunPod와 Vast.ai는 이 항목의 규칙이 다릅니다. RunPod는 자체 운영 등급(Secure Cloud)과 공급자 네트워크(Community Cloud)를 나누고, Vast.ai는 호스트가 가격을 정하는 마켓플레이스입니다. 아래는 두 서비스의 공식 문서에 적힌 구조입니다.
RunPod: 클라우드 등급과 중단 가능 여부를 나눠 본다
RunPod Pod은 두 등급으로 나뉩니다. Secure Cloud는 T3/T4 등급 데이터센터에서 운영되며, 문서는 프로덕션과 민감한 데이터에 이쪽을 권합니다. Community Cloud는 개인 공급자를 연결하는 P2P 방식으로, 신뢰성은 공급자마다 다르고 가격은 더 낮은 편입니다. 문서에 따르면 Community Cloud는 공인 IP가 보장되지 않아 SSH 포트가 외부에서 닿지 않을 수 있고, 네트워크 볼륨은 Secure Cloud에서만 쓸 수 있습니다. RunPod는 현재 Community Cloud의 신규 호스트를 받지 않는다고 밝히고 있으며, 기존 자원은 계속 제공됩니다.
중단 조건도 따로 봐야 합니다. API 문서는 인터럽터블(interruptible) Pod이 더 싸게 빌릴 수 있는 대신 다른 Pod에 자원을 주기 위해 언제든 멈출 수 있다고 설명합니다. 온디맨드 Pod은 다른 사용자가 밀어낼 수 없고, 배포하려면 해당 구성의 최소 1시간 분량 크레딧이 필요합니다.
과금 규칙은 다음과 같습니다.
- 컴퓨트와 디스크는 초 단위로 과금되고, 네트워크 볼륨은 시간 단위입니다.
- 데이터 수신·송신(ingress·egress) 요금은 없습니다.
- 컨테이너 디스크는 Pod을 멈추면 지워지고 과금도 멈춥니다. 볼륨 디스크는 Pod을 삭제할 때까지 남으며, 멈춘 동안의 단가가 실행 중보다 높습니다.
- 잔액이 0이 되면 Pod이 자동으로 멈춥니다. 네트워크 볼륨이 없는 Pod은 종료되고 데이터를 복구할 수 없습니다.
- 세이빙 플랜은 신규 구매가 중단됐습니다(기존 플랜은 만료까지 유지).
Vast.ai: 호스트 마켓플레이스와 세 가지 임대 유형
Vast.ai는 호스트가 장비와 가격을 올리는 마켓플레이스입니다. 임대 유형은 세 가지입니다.
- 온디맨드: 호스트가 정한 고정 가격, 임대 기간 동안 자원 보장, 높은 우선순위. 최대 임대 기간은 오퍼 카드에 표시됩니다.
- 리저브드: 온디맨드를 선불로 약정해 할인받는 방식으로, 문서는 최대 50% 할인을 제시합니다. 기존 온디맨드 인스턴스를 전환해 씁니다.
- 인터럽터블: 입찰 방식의 최저가 유형입니다. 더 높은 입찰이나 온디맨드 요청이 오면 일시정지됩니다. 일시정지 중에도 데이터는 남지만 인스턴스는 쓸 수 없고, 우선순위를 되찾으면 자동으로 재개됩니다.
임대 뒤에는 유형을 바꿀 수 없습니다(온디맨드에서 리저브드로의 전환은 예외).
과금 규칙은 RunPod와 몇 군데에서 다릅니다.
- 컴퓨트는 실제 사용 초 단위로 과금됩니다.
- 스토리지는 인스턴스가 존재하는 동안 실행 여부와 관계없이 과금되고, 문서상 멈춘 인스턴스의 스토리지가 보통 더 비쌉니다. 과금을 멈추려면 인스턴스를 삭제해야 합니다.
- 업로드·다운로드 대역폭이 바이트 단위로 과금되며, 단가는 호스트가 정합니다. 데이터가 많은 작업은 이 항목이 총액을 크게 바꿀 수 있습니다.
- 인스턴스를 시작하기 전에 크레딧을 충전해야 합니다. 잔액이 0이 되면 인스턴스가 멈추고, 결제 수단이 없으면 인스턴스와 데이터가 삭제 대상이 됩니다.
- 신뢰도 점수가 높은 호스트일수록 가격이 높은 경향이 있다고 문서에 적혀 있습니다. 장시간 작업 전에는 호스트의 신뢰도 점수를 확인하라고 권합니다.
총액은 중단·스토리지·전송을 합쳐 계산한다
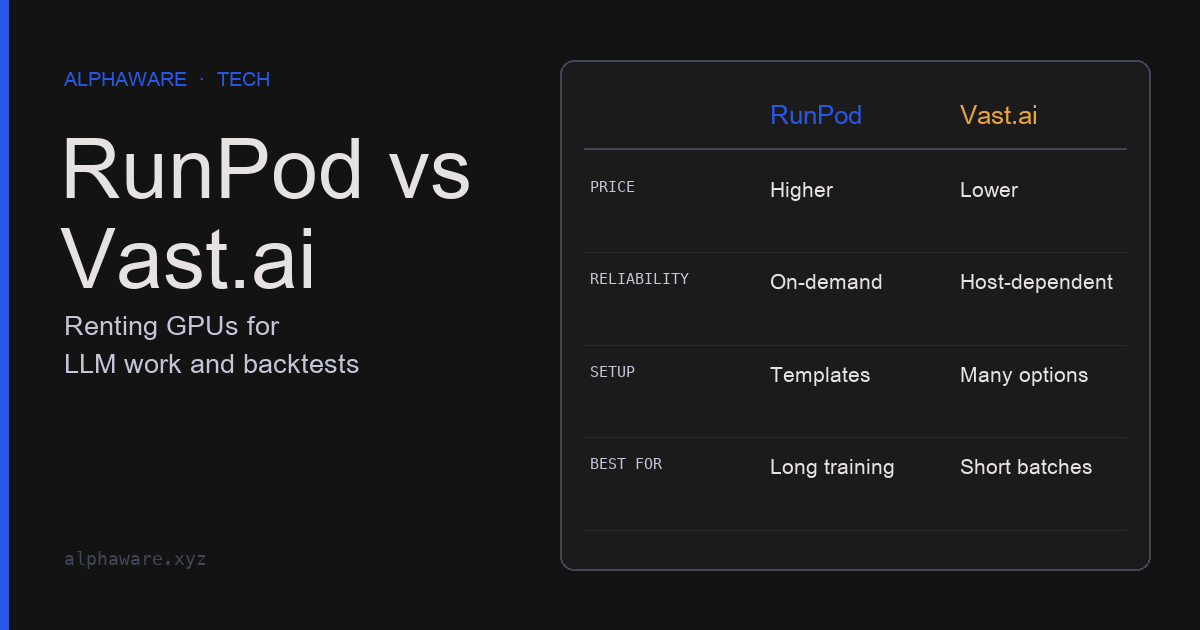
두 서비스의 차이를 항목별로 놓으면 다음과 같습니다.
| 비교 항목 | RunPod | Vast.ai |
|---|---|---|
| 가격 결정 | RunPod가 GPU·등급별로 게시 | 호스트별 오퍼 |
| 중단 가능한 저가 유형 | 인터럽터블 Pod(언제든 정지 가능) | 인터럽터블(입찰, 일시정지 후 재개) |
| 약정 할인 | 세이빙 플랜 신규 판매 중단 | 리저브드(최대 50%, 선불) |
| 컴퓨트 과금 단위 | 초 | 초 |
| 멈춘 동안 디스크 | 볼륨 디스크는 실행 중보다 높은 단가 | 인스턴스 삭제 전까지 과금, 보통 더 높음 |
| 데이터 전송 | ingress·egress 요금 없음 | 업·다운로드 바이트 과금, 호스트별 단가 |
| 시작 조건 | 온디맨드는 최소 1시간 분량 크레딧 | 시작 전 크레딧 충전 |
양사 공식 문서 기준(2026년 11월 3일 확인). 단가는 표에 넣지 않았습니다.
같은 작업의 비용을 비교하려면 이 항목을 한 식에 넣습니다. 아래 코드의 단가는 모두 가상 값이며, 시간당 요금이 낮은 쪽이 전송 요금과 재실행 때문에 총액에서 역전될 수 있다는 구조만 보여 줍니다.
# 모든 단가는 계산 구조를 보이기 위한 가상 값이다. 실제 요금은 각 서비스의 가격 페이지에서 확인한다.
def job_cost(gpu_per_hr, run_hours, disk_gb, disk_per_gb_month, idle_hours=0.0,
             idle_disk_per_gb_month=None, egress_gb=0.0, egress_per_gb=0.0,
             rerun_fraction=0.0):
    hours_per_month = 730
    idle_rate = disk_per_gb_month if idle_disk_per_gb_month is None else idle_disk_per_gb_month
    compute = gpu_per_hr * run_hours * (1 + rerun_fraction)   # 중단 뒤 다시 돌린 시간 포함
    storage = disk_gb * (disk_per_gb_month * run_hours + idle_rate * idle_hours) / hours_per_month
    transfer = egress_gb * egress_per_gb
    return round(compute + storage + transfer, 2)

# 가상 시나리오: 같은 10시간 작업. B는 결과 200GB 전송 요금이 있고 중단 때문에 30%를 다시 돌린다.
# 두 경우 모두 작업 뒤 디스크를 일주일(168시간) 남겨 둔다.
offer_a = job_cost(gpu_per_hr=1.00, run_hours=10, disk_gb=200, disk_per_gb_month=0.10,
                   idle_hours=168, idle_disk_per_gb_month=0.20)
offer_b = job_cost(gpu_per_hr=0.60, run_hours=10, disk_gb=200, disk_per_gb_month=0.10,
                   idle_hours=168, idle_disk_per_gb_month=0.20,
                   egress_gb=200, egress_per_gb=0.02, rerun_fraction=0.3)

assert offer_a == 19.48
assert offer_b == 21.28                      # 시간당 40% 싸도 총액은 더 크다
assert job_cost(0.60, 10, 200, 0.10, 168, 0.20) == 15.48   # 전송·재실행이 없으면 더 싸다
실제 비교에는 같은 GPU 모델과 메모리, 같은 작업 시간을 기준으로 각 서비스의 가격 페이지에서 단가를 넣습니다. 재실행 비율은 추측하지 말고, 짧은 시험 작업에서 중단과 재시작 기록을 남겨 추정합니다.
작업별 선택 기준
짧은 실험과 프로토타이핑
몇 시간짜리 작업은 중단 위험의 비용이 작습니다. 인터럽터블 유형이나 저가 오퍼를 써도 다시 돌리는 부담이 크지 않습니다. 다만 데이터셋을 매번 내려받는다면 Vast.ai에서는 호스트별 대역폭 단가를, RunPod Community Cloud에서는 공인 IP 미보장 조건을 확인합니다.
장시간 학습과 파인튜닝
중간에 멈추면 체크포인트 이후의 시간이 모두 재실행 비용이 됩니다. 중단 없는 유형(RunPod 온디맨드, Vast.ai 온디맨드·리저브드)을 기본으로 보고, Vast.ai 온디맨드라면 오퍼 카드의 최대 임대 기간이 작업 기간보다 긴지 확인합니다. 저가 유형을 쓰려면 체크포인트 간격을 짧게 잡고 체크포인트를 인스턴스 밖 저장소에 둡니다.
병렬 배치 백테스트와 파라미터 탐색
독립 작업으로 나눌 수 있으면 중단된 조각만 다시 돌리면 됩니다. 이 경우 인터럽터블 유형의 낮은 단가가 의미 있습니다. 각 조각이 같은 입력으로 같은 결과를 내도록 만들고, 끝난 조각의 결과를 즉시 외부 저장소에 쓰는 것이 전제입니다. 탐색 범위를 넓히는 만큼 과적합 위험도 커지므로 과적합 방지 칼럼의 검증 절차를 함께 적용합니다.
상시 켜 두는 추론 서비스
초 단위 과금은 켜 둔 시간만큼 그대로 누적됩니다. 24시간 운영이 필요하다면 월 단위 사용 시간을 기준으로 약정 할인, 서버리스형 과금, 전용 서버, 자체 장비를 같은 조건에서 비교합니다. 자체 장비의 판단 기준은 퀀트 개발 환경 칼럼에 정리했습니다.
중단을 전제로 작업을 설계한다
어느 서비스를 쓰든 결과를 인스턴스 디스크에만 두지 않습니다. RunPod의 컨테이너 디스크는 Pod을 멈추면 지워지고, 네트워크 볼륨이 없는 Pod은 잔액이 0이 되면 데이터를 복구할 수 없습니다. RunPod 문서도 장기 보관용으로 설계되지 않았다며 중요한 데이터는 따로 백업하라고 안내합니다. Vast.ai는 일시정지 중 데이터를 보존하지만, 문서는 자주 저장하고 중요한 결과는 클라우드 저장소에 두며 체크포인트를 쓰라고 권합니다.
작업 설계의 최소 조건은 세 가지입니다. 체크포인트와 결과를 인스턴스 밖에 쓰고, 재시작한 작업이 마지막 체크포인트부터 이어지며, 같은 입력으로 다시 돌려도 결과가 같아야 합니다. 이 조건을 갖추면 저가 유형을 쓸 수 있는 작업의 범위가 넓어집니다. 작업이 끝나면 인스턴스와 남은 볼륨을 정리해 유휴 스토리지 요금을 막습니다.
RunPod 레퍼럴 링크로 가입하면 첫 크레딧 보너스가 적용됩니다. Vast.ai도 가격 비교용으로 함께 확인해보세요.
자료와 적용 범위
- RunPod 가격 페이지: GPU·등급별 현재 단가(이 글에는 옮기지 않음).
- RunPod Pod 가격 문서: 초 단위 과금, 전송 요금 없음, 디스크 유형별 과금, 잔액 0 처리, 세이빙 플랜 중단.
- RunPod Pod 선택 가이드: Secure Cloud와 Community Cloud 비교, Community 신규 호스트 중단.
- RunPod Pod 생성 API: 인터럽터블 Pod의 정지 조건, 기본 클라우드 유형.
- Vast.ai 가격 문서: 초 단위 과금, 스토리지·대역폭 과금, 크레딧과 잔액 0 처리, 신뢰도 점수와 가격.
- Vast.ai 인스턴스 유형: 온디맨드·리저브드·인터럽터블의 우선순위와 일시정지 시 데이터.
- 이 글은 두 서비스의 실제 성능, 가용성, 중단 빈도를 측정하지 않았고, 어느 쪽이 항상 더 싸다고 주장하지 않습니다.